| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | 4 | 5 | ||
| 6 | 7 | 8 | 9 | 10 | 11 | 12 |
| 13 | 14 | 15 | 16 | 17 | 18 | 19 |
| 20 | 21 | 22 | 23 | 24 | 25 | 26 |
| 27 | 28 | 29 | 30 |
- dreamhack
- webhacking
- 더 메뉴
- 네트워크
- 리눅스마스터
- phpreg
- 리눅스
- 짝수는싫어요
- 드림핵
- 문제풀이
- 중앙값구하기
- 프로그래머스
- 파이썬
- php
- 나머지구하기
- 리눅스마스터2급
- 피자나눠먹기3
- XSS
- 웹해킹
- 피자나눠먹기1
- OSI 7계층
- sql_injection
- XAMPP설치
- PHP 개발환경
- visualcode
- 피자나눠먹기2
- 아파치
- web
- 웹
- XAMPP
- Today
- Total
이것저것
[리버싱 1-1주차] 컴퓨터 구조 본문
컴퓨터는 크게 3가지로 구성되어 있다.
CPU, 메모리, 디스크
CPU
CPU(중앙처리장치)는 컴퓨터에서 실제 연산과 명령어 처리를 담당하는 핵심 장치이다.
핵심 개념
역할 : 프로그램의 명령어를 해석하고 실행하는 컴퓨터는 두뇌 역할
클럭(Clock) : CPU 속도는 헤르츠(Hz) 단위의 클럭 수로 표현되며, 1초에 몇 번의 명령어 사이클을처리할 수 있는지를 나타냄
오버클럭(Overclock)
제조사가 설정한 기본 클럭보다 강제로더 높여 성능을 끌어올리는 것
처리 속도는 빨라지지만, 발열 및 전력 소모가 늘고 CPU에 과부화가 걸릴 위험이 있음
CPU와 다른 구성요소의 관계
CPU는 메모리에서 명령어와 데이터를 읽어와 처리하고, 결과를 다시 메모리나 디스크에 저장한다. 즉, CPU 단독으로 동작하는 게 아니라 메모리, 디스크, IO 장치와 상호작용하면서 컴퓨터 전체 시스템이 굴러가는 구조
CPU의 구성도
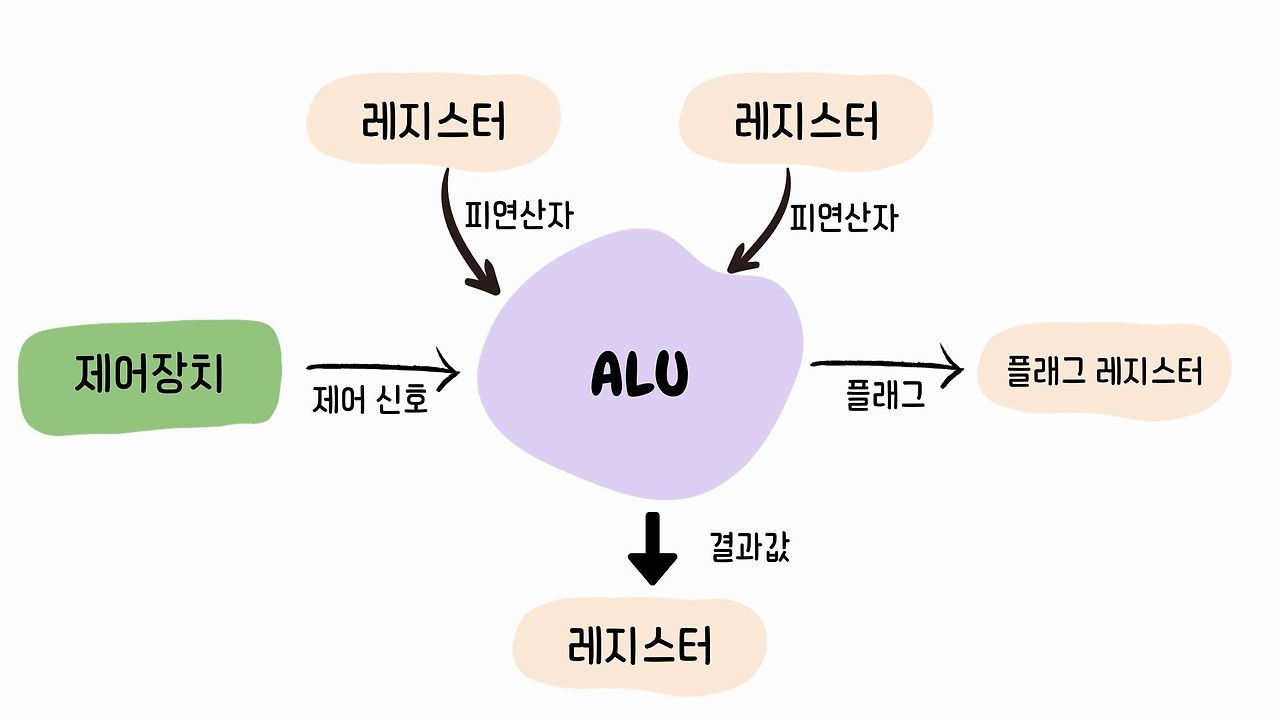
CPU의 내부 구성은 크게 산술/논리 연산 장치(ALU), 제어 장치와 레지스터로 구성되어 있다. 산술 연산은 덧셈을 수행하는 것이고, 제어 장치는 신호를 통해 데이터 흐름을 통제하며, 레지스터는 CPU 내부의 메모리이다.
산술 논리 연산 장치(ALU)
산술적인 연산과 논리적인 연산을 담당하는 장치로, 가산기, 보수기, 누산기, 기억 레지스터, 데이터 레지스터 등으로 구성된다. 캐시나 메모리에서 읽어온 데이터는 레지스터에 저장되고, ALU가 그 데이터로 덧셈, 곱셈 등의 연산을 수행한다. 부동 소수점 연산 장치(FPU), 정수 연산 장치, 논리 연산(AND, OR) 장치 등이 여기 포함된다.
제어 장치
CPU가 자신과 주변 기기를 제어하는 장치로, 아래 세 요소로 구성된다.
- 프로그램 계수기(PC) : 프로그램 수행 순서를 제어
- 명령 레지스터(IR) : 현재 수행 중인 명령어를 임시로 기억
- 명령 해독기 : 명령 레지스터에 담긴 명령을 해독해서 실행할 장치에 제어 신호를 보냄
제어 장치를 구현하는 방식은 아래 두 가지가 있음
- Hardwired(고정 배선 제어) : 회로로 직접 구현. 고속이지만 고가이고, RISC 시스템에 사용
- Micro Program : ROM에 미리 저장해둔 신호 조합을 필요할 때 꺼내 쓰는 소프트웨어 방식, 속도는 낮지만 저렴하고 CISC에 사용
레지스터
CPU 내부에 있는 기억 장치로, 두 종류로 구분된다.
- 범용 레지스터(General-Purpose Register) : 산술 연산 논리 장치가 사용
- 전용 레지스터(Dedicated-Purpose Register) : PC 등 특수 목적에 사용
레지스터의 세부 종류
| IR (Instruction Register) | 현재 수행 중인 명령어를 저장 |
| PC (Program Counter) | 다음 명령이 저장된 메모리 주소를 가리킴 |
| AC (Accumulator) | 산술·논리 연산의 결과를 임시로 기억 |
명령어 구조
명령어 = 동작 코드(Op-code) + 오퍼랜드(Operand)
- 동작 코드 : 명령어가 어떤 동작을 할지 구분
- 오퍼랜드 : 명령어 실행에 필요한 자료나 그 자료의 저장 위치
명령어 수행 과정
CPU가 명령 하나를 처리하는 4단계
1. 읽기(Fetch) : 메모리에서 명령어를 가져옴
2. 해석(Decode) : 명령어를 해석
3. 실행(Execute) : 명령어를 수행
4. 기록(Write Back) : 결과를 저장
Fetch 단계에서는 PC가 가리키는 주소의 명령어를 가져오면서 PC 값이 증가하고, 가져온 명령어를 IR에 로드된 뒤 ALU에서 실제 처리된다.
RISC와 CISC
RISC(Reduced Instruction Set Computer) : 명령어 세트를 단순화해서, 단순한 명령들을 조합해 하나의 기능을 수행한다. 한 사이클에 한 명령어 처리 가능, 파이프라이닝 슈퍼스칼라 가능
CISC(Complex Instruction Set Computer) : 하나의 기능을 하나의 명령어로 처리한다. 명령어마다 여러 사이클 소요, 명령어 집합이 다양해질수록 구조가 복잡해진다. 예) CISC의 MULT 5:7, 4:3 한 줄이 RISC에서는 LOAD -> LOAD -> PROD -> STORE 처럼 여러 단순 명령으로 쪼개짐
EPIC (RISC의 한계를 보완)
HP와 Intel이 공동 설계한 64비트 명령어셋 컴파일 시점에 병렬 실행 가능한 명령어를 미리 지정해둬서, 기존 RISC의 분기 예측, 메모리 지연 문제를 소프트웨어 차원에서 해결하려는 방식
메모리
메모리는 "저장"이라는 뜻이다. 컴퓨터에는 크게 두 가지 저장 개념이 있다.
1. 오래 저장하는 것 : 파일 형태로 디스크(하드디스크)에 저장됨
2. 잠깐 저장하는 것 : 메모리는 휘발성으로 정보를 잠깐 저장함
메모리에 저장되는 건 명령어나 데이터 형태인데, 프로그램을 종료하거나 컴퓨터를 끄면 사라지는 경우가 있다. 이렇게 단기적으로만 기억하는 메모리가 굳이 존재하는 이유는, 컴퓨터 전체 성능을 높이기 위해서다.
CPU가 일을 하려면 명령어/데이터가 하드디스크에 버스를 타고 전달되어야 하는데, 버스는 상대적으로 느다. 그래서 CPU는 하드디스크 내용 일부를 메모리에 미리 올려두고 처리한다. 메모리는 공간이 한정적이라 프로그램 전체가 아니라 일부만 올라간다.
메모리 동작 원리
메모리는 반도체(기억 소자)로 구성되며 1과 0 두 상태로 정보를 저장한다. 저장 장치(하드디스크 등)와 다른 결정적 특징은 휘발성이라는 것이다.
- 주소는 행(Row)과 열(Column)로 구성된 행렬 구조
- RAS : 행 주소 신호, CAS : 열 주소 신호 RAS로 행을 찾고 CAS로 정확한 열을 확인
- 리프레시 : 정보 유지를 위한 주기적 재충전
- 사이클 시간 = 메모리 액세스 시간 + 리프레시 시간
메모리 분류
저장 방식에 따른 분류
- SRAM : 정적 방식, 재충전 불필요
- DRAM : 동적 방식, 캐패시터 충전 방식이라 주기적 재충전 필요
형태에 따른 분류
- DIP -> SIMM -> DIMM(64비트, 현재 가장 보편적) -> RIMM(Rambus 기반, 고속)
사용처에 따른 분류
- ROM BIOS : 한 번만 기록 가능
- EPROM : 자외선으로 기록 내용 수정
- EEPROM : 전기 신호로 기록 내용 수정
- 플래시 메모리 : EEPROM의 변형, 전원 없어도 내용 보존 + 자유로운 수정 가능. SSD의 기반 기술
캐시 메모리 (Cache Memory)
메인 메모리와 CPU 간 속도 차이를 줄이는 중간 버퍼 역할의 메모리
- 필요한 데이터가 캐시에 있으면 Hit, 없으면 Miss
- 있을 확률을 Hit Ratio라 함
쓰기 정책
- Write-Through : 캐시와 메모리에 동시 기록. 단순하지만 느림
- Write-Back : 캐시에만 먼저 기록, 이후 한꺼번에 메모리 반영. 효율적인지만 구조 복잡
매핑 방식
- 직접 매핑 : 간단하지만 충돌 잦음
- 완전 연관 매핑 : 유연하지만 검색 회로 복잡
- 집합 연관 매핑 : 두 방식의 절충안, 실무에서 많이 사용
교체 알고리즘
- FIFO, LRU (가장 오래 미사용된 것 교체, 가장 효과적), LFU, Random, Optimal
가상 메모리 (Virtual Memory)
물리적 메모리의 한계를 극복하기 위해 디스크 일부를 메모리처럼 사용하는 기법
- 가상 주소(논리적 주소) : 프로그램이 사용하는 주소이며, 실제 물리 주소와는 운영체제가 변환해줌
- 페이지 : 물리 메모리에 데이터를 적재할 때 나누는 일정 크기의 블록 단위
- 페이지 폴트(Page Fault) : 필요한 페이지가 메모리에 없는 경우
가상 기억장치 분할 기법
- 페이징 기법 : 일정 크기(페이지) 단위로 나눠 적재
- 세그먼트 기법 : 의미 단위(코드부, 데이터부 등)로 나눠 적재, 크기가 제각각이라 외부 단편화 발생 가능
- 페이지드 세그멘테이션 : 세그먼트의 의미 연결을 유지하면서 페이징으로 관리해 단편화를 보완한 절충 방식
디스크
디스크는 반영구적 저장 장소다. 파일이 저장되어 있고, 지우거나 고장 나지 않으면 계속 유지된다는 점에서 메모리(휘발성)와 대비된다.하드디스크는 LP판/CD를 여러 장 겹쳐놓은 구조와 비슷하게 생겼고, 그 안에서 디스크가 회전하며 데이터를 찾는다. 이 회전 속도가 RPM(분당 회전수)이며, 자동차 바퀴 RPM과 같은 개념이다. 디스크의 관심사는 크게 용량과 속도 두 가지이다.
하드 디스크가 SSD로 간 이유
SSD(Solid State Drive)는 낸드플래시 메모리로 만든 저장 매체로, 메모리 방식의 하드디스크라고 이해하면 된다.
하드 디스크는 실린더를 돌려서 데이터를 찾아가는 구조지만, SSD는 메모리처럼 즉시 접근(access)이 가능해 속도 차이가 비교가 안 된다. 다만 컴퓨터의 기본 구조(CPU-메모리-디스크)는 SSD로 바뀌어도 변하지 않는다. 디스크의 역할 자체는 동일하고, 구현 방식만 메모리 기술로 대체된 것이다.
디스크 스케줄링
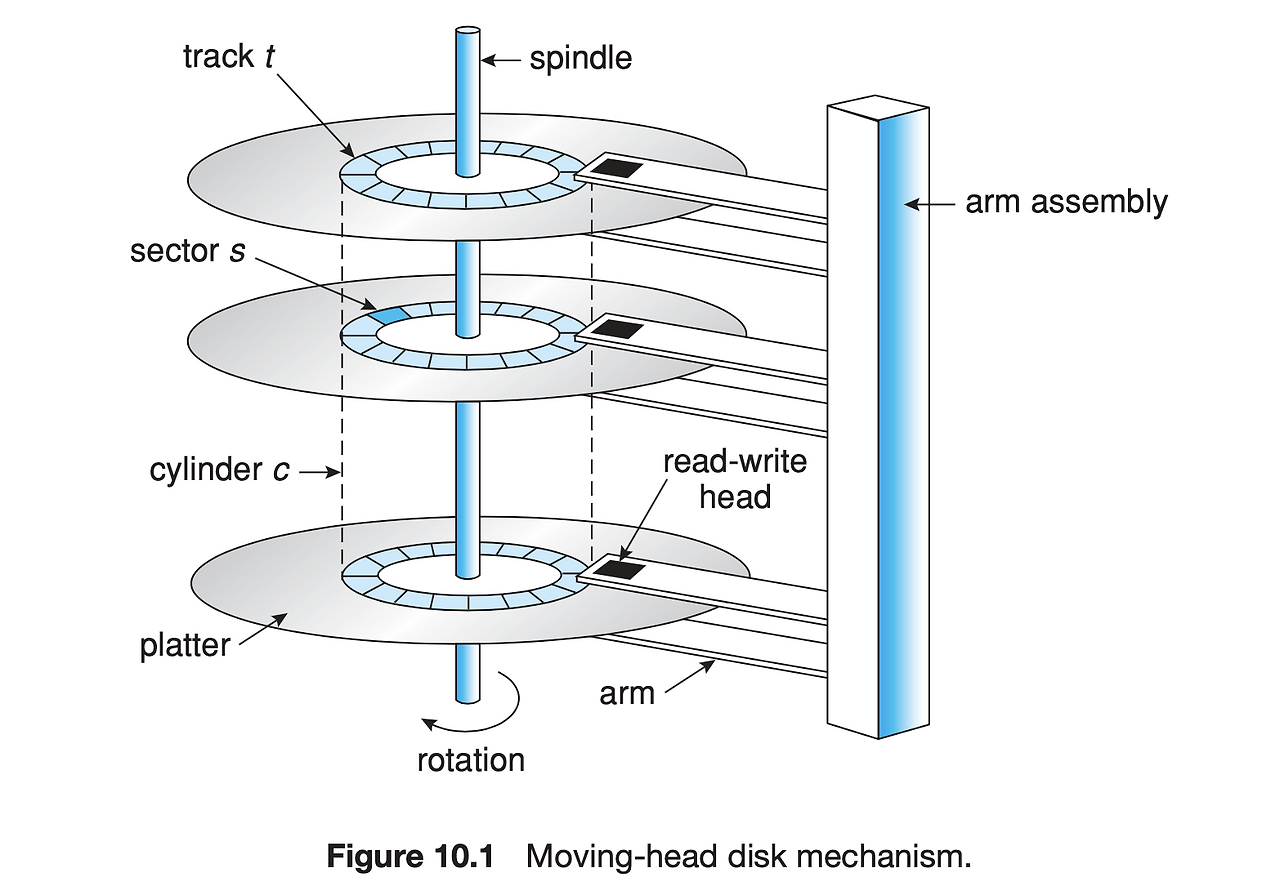
디스크 내 정보가 저장된 구역을 섹터라 하고, 헤드가 움직이며 섹터를 찾아 데이터를 읽는다.
파일은 물리적으로 여러 조각으로 분산 저장되는 경우가 많아서, 헤드가 여러 위치를 오가며 찾는 시간이 곧 디스크 속도다. 디스크 조각모음은 분산된 조각들을 한곳에 모아 헤드 이동을 줄여 접근성을 높이는 작업인데, SSD가 대중화된지금은 거의 사라졌다. 디스크 스케줄링은 밀려있는 요청을 어떤 순서로 처리할지에 대한 정책이다.(먼저 요청 온 것부터 처리, 검색 시간이 짧은 것 부터 처리 등)
디스크의 확장 RAID
RAID는 여러 개의 하드디스크를 연결해서 하나의 저장장치처럼 쓰는 기법이다.
목적은 접근 속도, 가용성 향상, 물리적 용량 제약 극복, 디스크 장애 시 데이터 무결성 보장이다. 패리티(Parity)는 디스크 오류 시 데이터 복구를 위한 정보(오류 체크 비트)를 말한다.
RAID 레벨별 핵심
| 레벨 | 방식 | 특징 |
| RAID 0 (Striping) | 데이터를 여러 디스크에 분할 저장, 중복 없음 | I/O 성능 최고, 가용용량 100%, 장애 시 복구 불가 |
| RAID 1 (Mirroring) | 동일 데이터를 중복 디스크에 그대로 복사 | 안정성 최고, 가용용량 50%, 고비용 |
| RAID 2 (Hamming Code) | 비트 단위분할 + 해밍코드로 오류정정 | 이론적 개념, 상업적으로는 거의 안 씀 |
| RAID 3 | 데이터는 여러 디스크에, Parity는 별도 디스크 1개 | 최소 3개 드라이브, Management SW가 통합 관리 |
| RAID 4 | RAID 3과 유사하지만 각 디스크 그룹을 독립적으로 관리 | 블록 단위 I/O, NAS에 활용 |
| RAID 5 | 데이터+Parity를 함께 분산 저장 (Parity 전용 디스크 없음) | RAID 4의 병목 현상 해결, 가용용량 약 75%, 단일 실패지점 없음 |
| RAID 0+1 | RAID 0 (속도)+RAID 1(미러링) 결합 | 속도와 안정성 모두 확보 |
| RAID-DP | 패리티 디스크 2개 (이중 패리티) | RAID-5보다 약 70만 배 안정성 향상(확률적 계산 기준) |